
Explicabilidad (XAI) en ciberseguridad: ¿por qué la IA tomó esa decisión?
Hola mis estimados lectores:
Empezamos hoy imaginando que somos los responsables de seguridad de una infraestructura crítica. Son las tres de la mañana y nuestro sistema de detección de intrusiones basado en inteligencia artificial (IA) ha bloqueado de forma automática todo el tráfico proveniente de una sucursal bancaria en el extranjero.
El sistema ha detectado un patrón que, según su modelo entrenado con millones de datos, coincide con un ataque de denegación de servicio. La sucursal queda incomunicada.
Horas después, descubres que era una operación legítima de actualización de software. Cuando preguntas al sistema por qué tomó esa decisión, la respuesta que obtienes es un silencio digital o, en el mejor de los casos, una cifra de confianza del 99,8%. No hay una explicación. No hay un “porqué”. Solo hay un resultado.
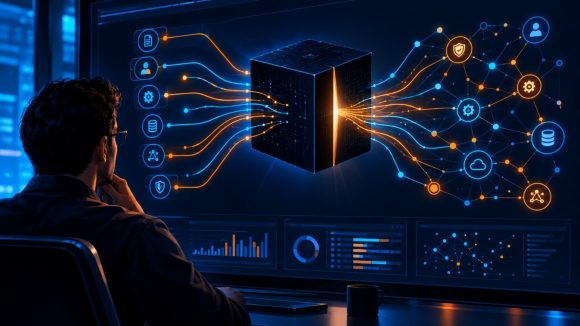
Esta escena, que parece sacada de un thriller tecnológico y que este autor ha usado en el día de hoy como preámbulo, es el pan de cada día en la ciberseguridad moderna. Y es precisamente el problema que la Explicabilidad (XAI, por sus siglas en inglés) pretende resolver.
La IA se ha convertido en el guardián silencioso de nuestras redes, pero es un guardián que no rinde cuentas. En un dominio donde una decisión errónea puede costar millones o exponer datos sensibles, aceptar un “porque sí” es un lujo que no podemos permitirnos. La XAI no es un adorno académico; es la herramienta que nos permite auditar la lógica del guardián.
Para entender la magnitud del desafío, primero debemos aceptar una verdad incómoda: los modelos de IA más potentes que utilizamos hoy en ciberseguridad, como las redes neuronales profundas, son cajas negras funcionales.
Esto significa que, aunque tengamos acceso total al código y a los parámetros del modelo, la complejidad de sus cálculos internos es tal que resulta imposible para un humano rastrear paso a paso por qué una determinada combinación de paquetes de red ha desencadenado una alerta de malware.
El sistema aprende patrones que ni siquiera nosotros sabíamos que existían, pero no puede articularlos en un lenguaje que un analista de seguridad pueda entender bajo presión. En un Centro de Operaciones de Seguridad (SOC), donde los analistas reciben cientos de alertas diarias, un sistema que dice “esto es malo” sin dar más detalles genera dos reacciones peligrosas: o se ignora la alerta por desconfianza, o se acepta ciegamente por pereza cognitiva. Ambas son fatales.
Aquí es donde la XAI entra en juego, pero no como una solución mágica, sino como un campo de batalla técnico y filosófico. Existen dos grandes enfoques para arrojar luz sobre la caja negra.
El primero es usar modelos intrínsecamente interpretables, como los árboles de decisión o las regresiones lineales, que son fáciles de leer pero que, en ciberseguridad, a menudo se quedan cortos frente a ataques sofisticados que requieren la sutileza de una red profunda.
El segundo enfoque, y el más extendido hoy, es el de las explicaciones post-hoc: utilizar una herramienta externa para “interrogar” al modelo después de que ha tomado una decisión .
Dentro de este segundo grupo, brilla con luz propia una técnica llamada SHAP (Shapley Additive Explanations). ¿Cómo funciona? Imagina que el modelo es un jurado que ha emitido un veredicto de culpabilidad sobre un fragmento de tráfico de red. SHAP se encarga de calcular cuánto ha aportado cada “miembro del jurado” (cada característica del paquete: la IP de origen, el puerto, el tamaño del payload, la hora de envío) al veredicto final.
Si el sistema ha bloqueado una conexión, SHAP nos dirá, por ejemplo, que la IP de origen contribuyó en un 60% a la decisión, mientras que el puerto lo hizo en un 25% y el resto fue irrelevante . Para un analista, esto lo cambia todo.
Ya no está ante un oráculo inescrutable; está ante un informe que le permite decir: “Vale, el sistema bloqueó esto porque la IP pertenece a un rango conocido por atacar, pero el puerto es el estándar de mi servidor web. Voy a investigar más antes de descartar la alerta”.
Sin embargo, sería ingenuo pensar que la XAI es una varita mágica que solo trae bondades. La implantación de la explicabilidad en ciberseguridad introduce paradojas fascinantes y riesgos nuevos que debemos considerar con rigor. El primer gran dilema es el de la seguridad de la explicación.
Cuando un sistema XAI genera una explicación detallada de por qué ha clasificado un tráfico como malicioso, está revelando información sobre cómo funciona su modelo de detección.
Si un atacante tiene acceso a esas explicaciones (por ejemplo, si el sistema las registra en un log o las muestra en una interfaz mal protegida), puede utilizarlas para evadir el sistema en el futuro.
El atacante aprenderá qué características debe modificar para que el modelo deje de considerarlo una amenaza, ajustando su malware o su tráfico para que se parezca más a lo que el sistema considera “normal” . Es decir, la herramienta que usamos para confiar en el sistema puede convertirse en el mapa que el enemigo usa para esquivarlo.
El segundo dilema es el del trade-off entre precisión y transparencia. En términos generales, cuanto más complejo es un modelo (y por tanto, más preciso y capaz de detectar ataques sutiles), más difícil es de explicar.
Si forzamos al sistema a ser tan simple que cualquier analista pueda entenderlo en dos segundos, probablemente estaremos dejando pasar amenazas que solo un modelo complejo podría haber detectado.
La XAI no elimina la caja negra; negocia con ella. Nos da una traducción aproximada, no una verdad absoluta. Y los analistas deben ser conscientes de que la explicación que reciben es, en sí misma, otro modelo que intenta adivinar qué pasó dentro del primero. Puede haber errores en la explicación.
A pesar de estos riesgos, el camino hacia la XAI en ciberseguridad es inevitable, y no solo por razones técnicas, sino también legales y éticas. Imaginemos un escenario en el que un sistema de IA identifica erróneamente a un empleado como un insider threat (amenaza interna) y bloquea su acceso a sistemas críticos.
Si la organización no puede explicar por qué la IA tomó esa decisión, se enfrenta a un problema de cumplimiento normativo (como el RGPD en Europa, que exige el derecho a la explicación en decisiones automatizadas) y a un grave problema de confianza interna.
La explicabilidad se convierte así en un requisito de responsabilidad. No se trata solo de “hacer que la IA sea buena”, sino de poder determinar quién responde cuando la IA se equivoca. Si el analista entiende por qué el sistema falló, puede corregir el rumbo; si no lo entiende, es un rehén de su propia herramienta.
El futuro de la ciberseguridad no pasa por elegir entre IA opaca o IA explicable. Pasa por construir sistemas que sean conscientes de su propia incertidumbre y que sepan comunicarla. La próxima generación de herramientas de seguridad no solo dirá “ataque detectado”, sino que dirá “ataque detectado, y aquí están las tres razones principales, aunque hay un 15% de probabilidad de que sea un falso positivo debido a la similitud con el tráfico de actualizaciones”.
Ese nivel de matiz es lo que permite que un humano y una máquina colaboren de verdad. La XAI no está aquí para darnos respuestas absolutas, sino para darnos las preguntas correctas que debemos hacerle a la máquina. Y en ciberseguridad, hacer las preguntas correctas es, a menudo, la única diferencia entre un incidente contenido y un desastre anunciado.
Este artículo inaugura una serie dedicada a desentrañar la relación entre la Inteligencia Artificial y la ciberseguridad. En las próximas entregas abordaremos los riesgos de los modelos generativos, la seguridad de los agentes autónomos y la ética algorítmica en el ciberespacio.
Hoy empezamos por la base de la confianza: entender qué pasa por la cabeza de una máquina cuando decide bloquear (o no) un ataque. Porque, al final, la carrera nunca termina.
Nos vemos la próxima semana.
- Explicabilidad (XAI) en ciberseguridad: ¿por qué la IA tomó esa decisión?
- Análisis forense en la nube y redes corporativas: Cuando la evidencia no está en tus manos
- Análisis forense en Linux: El arte de leer el sistema que nunca duerme
- Análisis forense en dispositivos móviles: El testigo que siempre llevas contigo
- Análisis forense en Windows: El arte de interrogar al silencio digital
- ir aCódigo seguro »
- La Revolución es inclusión (+ Fotos y Video)
- ¿Por qué África rompe con Occidente y elige a Rusia?
- Explicabilidad (XAI) en ciberseguridad: ¿por qué la IA tomó esa decisión?
- Sabor y tradición: Boniatos hawaianos, torta de pescado y carne fría en salsa
- Mercados de Barrio: Mincin responde a los lectores de Cubadebate
- ir aEspeciales »
- Explicabilidad (XAI) en ciberseguridad: ¿por qué la IA tomó esa decisión?
- Análisis forense en la nube y redes corporativas: Cuando la evidencia no está en tus manos
- Autoridades alertan ante inminencia de lluvias intensas este fin de semana en Guantánamo
- “No se aceptan estudiantes humanos”: la primera escuela china que forma androides para el ámbito laboral
- Falla informática obliga a empresas y gobiernos a cerrar sitios web
- ir aCiencia y Tecnología »
Haga un comentario